Grundlegende Konzepte hinter der Web Audio API
Dieser Artikel erläutert einige der Audiotheorie-Grundlagen, auf denen die Funktionen der Web Audio API basieren. Er soll Ihnen dabei helfen, fundierte Entscheidungen zu treffen, wenn Sie das Audio-Routing Ihrer App entwerfen. Auch wenn Sie kein Tontechniker sind, vermittelt er Ihnen genügend Hintergrundwissen, um zu verstehen, warum die Web Audio API so funktioniert, wie sie funktioniert.
Audiographen
Die Web Audio API verarbeitet Audiooperationen innerhalb eines Audiokontexts und wurde entwickelt, um modulares Routing zu ermöglichen. Jeder Audioknoten führt eine grundlegende Audiooperation aus und wird mit einem oder mehreren weiteren Audioknoten verknüpft, um einen Audio-Routing-Graphen zu bilden. Mehrere Quellen mit unterschiedlichen Kanallayouts werden unterstützt, sogar innerhalb eines einzelnen Kontexts. Dieses modulare Design bietet die Flexibilität, komplexe Audiofunktionen mit dynamischen Effekten zu erstellen.
Audioknoten werden über ihre Ein- und Ausgänge verknüpft und bilden eine Kette, die mit einer oder mehreren Quellen beginnt, durch einen oder mehrere Knoten führt und schließlich an einem Ziel endet (Sie müssen jedoch kein Ziel angeben, wenn Sie nur Audiodaten visualisieren möchten). Ein einfacher, typischer Workflow für Web Audio könnte etwa so aussehen:
- Erstellen Sie den Audiokontext.
- Erstellen Sie Audioquellen innerhalb des Kontexts, beispielsweise
<audio>, einen Oszillator oder einen Stream. - Erstellen Sie Audioeffekte, beispielsweise Reverb-, Biquad-Filter-, Panner- oder Kompressorknoten.
- Wählen Sie das endgültige Ziel für die Audiodaten, beispielsweise die Lautsprecher des Computers des Benutzers.
- Verbinden Sie die Quellknoten mit null oder mehr Effektknoten und anschließend mit dem ausgewählten Ziel.
Hinweis: Die Kanalnotation ist ein numerischer Wert wie 2.0 oder 5.1, der die Anzahl der in einem Signal verfügbaren Audiokanäle darstellt. Die erste Zahl gibt die Anzahl der im Signal enthaltenen Audiokanäle mit vollständigem Frequenzbereich an. Die Zahl nach dem Punkt gibt die Anzahl der Kanäle an, die für Ausgänge mit Tieffrequenzeffekten (LFE) reserviert sind; diese werden oft Subwoofer genannt.

Jeder Ein- oder Ausgang besteht aus einem oder mehreren Audio-Kanälen, die zusammen ein bestimmtes Audiolayout darstellen. Jede diskrete Kanalstruktur wird unterstützt, einschließlich Mono, Stereo, Quad, 5.1 und so weiter.

Es gibt mehrere Möglichkeiten, Audio zu erhalten:
- Klang kann direkt in JavaScript durch einen Audioknoten erzeugt werden, beispielsweise durch einen Oszillator.
- Er kann aus rohen PCM-Daten erstellt werden, beispielsweise aus .WAV-Dateien oder anderen durch
decodeAudioData()unterstützten Formaten. - Er kann aus HTML-Medienelementen wie
<video>oder<audio>erzeugt werden. - Er kann aus einem WebRTC-
MediaStreamabgerufen werden, beispielsweise von einer Webcam oder einem Mikrofon.
Audiodaten: Was enthält ein Sample?
Bei der Verarbeitung eines Audiosignals findet eine Abtastung statt. Abtastung ist die Umwandlung eines kontinuierlichen Signals in ein diskretes Signal. Anders ausgedrückt: Eine kontinuierliche Schallwelle, etwa von einer live spielenden Band, wird in eine Folge digitaler Samples umgewandelt – ein zeitdiskretes Signal –, sodass ein Computer die Audiodaten in einzelnen Blöcken verarbeiten kann.
Weitere Informationen finden Sie auf der Wikipedia-Seite Sampling (signal processing).
Audiopuffer: Frames, Samples und Kanäle
Ein AudioBuffer wird durch drei Parameter definiert:
- die Anzahl der Kanäle (1 für Mono, 2 für Stereo usw.),
- seine Länge, also die Anzahl der Sample-Frames im Puffer,
- und die Abtastrate, also die Anzahl der pro Sekunde wiedergegebenen Sample-Frames.
Ein Sample ist ein einzelner 32-Bit-Gleitkommawert, der den Wert des Audiostreams zu einem bestimmten Zeitpunkt innerhalb eines bestimmten Kanals darstellt, etwa links oder rechts bei Stereo. Ein Frame beziehungsweise Sample-Frame ist die Menge aller Werte für alle Kanäle, die zu einem bestimmten Zeitpunkt wiedergegeben werden: alle Samples aller Kanäle, die gleichzeitig wiedergegeben werden – zwei bei Stereoton, sechs bei 5.1 usw.
Die Abtastrate ist die Anzahl dieser Samples – oder Frames, da alle Samples eines Frames gleichzeitig wiedergegeben werden –, die innerhalb einer Sekunde wiedergegeben werden, gemessen in Hz. Je höher die Abtastrate, desto besser die Klangqualität.
Betrachten wir einen Mono- und einen Stereo-Audiopuffer, jeweils eine Sekunde lang bei einer Rate von 44100 Hz:
- Der Mono-Puffer enthält 44.100 Samples und 44.100 Frames. Die Eigenschaft
lengthbeträgt 44.100. - Der Stereo-Puffer enthält 88.200 Samples, aber weiterhin 44.100 Frames. Die Eigenschaft
lengthbeträgt weiterhin 44100, da sie der Anzahl der Frames entspricht.
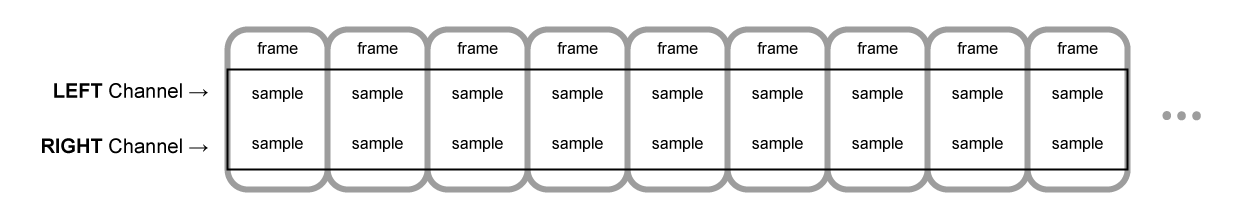
Wenn ein Puffer wiedergegeben wird, hören Sie zuerst den am weitesten links liegenden Sample-Frame, dann den direkt daneben, anschließend den nächsten und so weiter, bis zum Ende des Puffers. Bei Stereo hören Sie beide Kanäle gleichzeitig. Sample-Frames sind praktisch, da sie unabhängig von der Kanalanzahl sind und Zeit auf eine für präzise Audiomanipulation ideale Weise darstellen.
Hinweis: Um aus einer Frame-Anzahl eine Zeit in Sekunden zu erhalten, teilen Sie die Anzahl der Frames durch die Abtastrate. Um aus der Anzahl der Samples die Anzahl der Frames zu erhalten, müssen Sie den letzteren Wert nur durch die Kanalanzahl teilen.
Hier sind einige einfache Beispiele:
const buffer = new AudioBuffer({
  numberOfChannels: 2,
  length: 22050,
  sampleRate: 44100,
});
Hinweis: In digitalem Audio sind 44.100 Hz – alternativ dargestellt als 44,1 kHz – eine gängige Abtastfrequenz. Warum 44,1 kHz?
Erstens liegt der Hörbereich des menschlichen Gehörs ungefähr zwischen 20 Hz und 20.000 Hz. Nach dem Nyquist-Shannon-Abtasttheorem muss die Abtastfrequenz mehr als doppelt so hoch sein wie die maximale Frequenz, die reproduziert werden soll. Daher muss die Abtastrate größer als 40.000 Hz sein.
Zweitens müssen Signale vor der Abtastung tiefpassgefiltert werden, da andernfalls Aliasing auftritt. Während ein idealer Tiefpassfilter Frequenzen unter 20 kHz perfekt durchlassen würde, ohne sie abzuschwächen, und Frequenzen über 20 kHz perfekt abschneiden würde, ist in der Praxis ein Übergangsband erforderlich, in dem Frequenzen teilweise abgeschwächt werden. Je breiter dieses Übergangsband ist, desto einfacher und kostengünstiger lässt sich ein Anti-Aliasing-Filter herstellen. Die Abtastfrequenz von 44,1 kHz ermöglicht ein Übergangsband von 2,05 kHz.
Wenn Sie den obigen Aufruf verwenden, erhalten Sie einen Stereopuffer mit zwei Kanälen, der bei Wiedergabe in einem mit 44100 Hz laufenden AudioContext – was sehr häufig ist, da die meisten üblichen Soundkarten mit dieser Rate arbeiten – 0,5 Sekunden dauert: 22.050 Frames/44.100 Hz = 0,5 Sekunden.
const buffer = new AudioBuffer({
  numberOfChannels: 1,
  length: 22050,
  sampleRate: 22050,
});
Wenn Sie diesen Aufruf verwenden, erhalten Sie einen Monopuffer (Puffer mit einem Kanal), der bei Wiedergabe in einem mit 44.100 Hz laufenden AudioContext automatisch auf 44.100 Hz neu abgetastet wird – und somit 44.100 Frames ergibt – und 1,0 Sekunde dauert: 44.100 Frames/44.100 Hz = 1 Sekunde.
Hinweis: Die Neuabtastung von Audio ähnelt stark der Größenänderung eines Bildes. Angenommen, Sie haben ein Bild mit 16 × 16 Pixeln, möchten damit aber einen Bereich von 32 × 32 Pixeln füllen. Sie ändern seine Größe – oder tasten es neu ab. Das Ergebnis hat eine geringere Qualität; abhängig vom Skalierungsalgorithmus kann es unscharf oder kantig sein. Es funktioniert jedoch, und das skalierte Bild benötigt weniger Speicherplatz. Bei neu abgetastetem Audio ist es ähnlich: Sie sparen Speicherplatz, können aber in der Praxis hochfrequente Inhalte oder hohe Töne nicht korrekt reproduzieren.
Planare und verschachtelte Puffer
Die Web Audio API verwendet ein planares Pufferformat. Die linken und rechten Kanäle werden wie folgt gespeichert:
LLLLLLLLLLLLLLLLRRRRRRRRRRRRRRRR (for a buffer of 16 frames)
Diese Struktur ist in der Audioverarbeitung weit verbreitet und erleichtert die unabhängige Verarbeitung jedes Kanals.
Die Alternative ist ein verschachteltes Pufferformat:
LRLRLRLRLRLRLRLRLRLRLRLRLRLRLRLR (for a buffer of 16 frames)
Dieses Format ist verbreitet für das Speichern und Wiedergeben von Audio ohne umfangreiche Verarbeitung, beispielsweise .WAV-Dateien oder einen dekodierten MP3-Stream.
Da die Web Audio API für die Verarbeitung konzipiert ist, stellt sie nur planare Puffer bereit. Sie verwendet das planare Format, wandelt die Audiodaten jedoch in das verschachtelte Format um, wenn sie zur Wiedergabe an die Soundkarte gesendet werden. Umgekehrt beginnt die API beim Dekodieren einer MP3 mit dem verschachtelten Format und wandelt es zur Verarbeitung in das planare Format um.
Audiokanäle
Jeder Audiopuffer kann unterschiedlich viele Kanäle enthalten. Die meisten modernen Audiogeräte verwenden die grundlegenden Einstellungen Mono (nur ein Kanal) und Stereo (linker und rechter Kanal). Einige komplexere Systeme unterstützen Surround-Sound-Einstellungen wie Quad und 5.1, die dank ihrer hohen Kanalanzahl zu einem intensiveren Klangerlebnis führen können. Üblicherweise stellen wir die Kanäle mit den folgenden Standardabkürzungen dar:
| Name | Kanäle |
|---|---|
| Mono | 0: M: mono |
| Stereo | 0: L: left 1: R: right |
| Quad | 0: L: left 1: R: right 2: SL: surround left 3: SR: surround right |
| 5.1 | 0: L: left 1: R: right 2: C: center 3: LFE: subwoofer 4: SL: surround left 5: SR: surround right |
Hochmischen und Heruntermischen
Wenn die Kanalanzahl von Ein- und Ausgang nicht übereinstimmt, muss hoch- oder heruntergemischt werden. Dabei gelten die folgenden Regeln, die durch das Setzen der Eigenschaft AudioNode.channelInterpretation auf speakers oder discrete gesteuert werden:
| Interpretation | Eingangskanäle | Ausgangskanäle | Mischregeln |
|---|---|---|---|
speakers |
1 (Mono) |
2 (Stereo) |
Hochmischen von Mono auf Stereo. Der Eingangskanal M
wird für beide Ausgangskanäle (L und R) verwendet.output.L = input.M
|
1 (Mono) |
4 (Quad) |
Hochmischen von Mono auf Quad. Der Eingangskanal M
wird für die Nicht-Surround-Ausgangskanäle (L und
R) verwendet. Die Surround-Ausgangskanäle (SL und
SR) bleiben stumm.output.L = input.M
|
|
1 (Mono) |
6 (5.1) |
Hochmischen von Mono auf 5.1. Der Eingangskanal M
wird für den zentralen Ausgangskanal (C) verwendet. Alle anderen
(L, R, LFE, SL und
SR) bleiben stumm.output.L = 0output.C = input.M
|
|
2 (Stereo) |
1 (Mono) |
Heruntermischen von Stereo auf Mono. Beide Eingangskanäle ( L
und R) werden gleich gewichtet kombiniert, um den einzigen
Ausgangskanal (M) zu erzeugen.output.M = 0.5 * (input.L + input.R)
|
|
2 (Stereo) |
4 (Quad) |
Hochmischen von Stereo auf Quad. Die Eingangskanäle L
und R werden für die entsprechenden Nicht-Surround-Ausgangskanäle
(L und R) verwendet. Die Surround-Ausgangskanäle
(SL und SR) bleiben stumm.output.L = input.L
|
|
2 (Stereo) |
6 (5.1) |
Hochmischen von Stereo auf 5.1. Die Eingangskanäle L
und R werden für die entsprechenden Nicht-Surround-Ausgangskanäle
(L und R) verwendet. Die Surround-Ausgangskanäle
(SL und SR) sowie der Center- (C) und
Subwoofer-Kanal (LFE) bleiben stumm.output.L = input.L
|
|
4 (Quad) |
1 (Mono) |
Heruntermischen von Quad auf Mono. Alle vier Eingangskanäle ( L, R, SL und SR)
werden gleich gewichtet kombiniert, um den einzigen Ausgangskanal
(M) zu erzeugen.output.M = 0.25 * (input.L + input.R + input.SL + input.SR)
|
|
4 (Quad) |
2 (Stereo) |
Heruntermischen von Quad auf Stereo. Beide linken Eingangskanäle ( L und SL) werden gleich gewichtet kombiniert, um
den einzigen linken Ausgangskanal (L) zu erzeugen. Entsprechend
werden beide rechten Eingangskanäle (R und SR)
gleich gewichtet kombiniert, um den einzigen rechten Ausgangskanal
(R) zu erzeugen.output.L = 0.5 * (input.L + input.SL)output.R = 0.5 * (input.R + input.SR)
|
|
4 (Quad) |
6 (5.1) |
Hochmischen von Quad auf 5.1. Die Eingangskanäle L,
R, SL und SR werden für ihre
jeweiligen Ausgangskanäle verwendet. Die Center- (C) und
Subwoofer-Kanäle (LFE) bleiben stumm.output.L = input.Loutput.R = input.Routput.C = 0output.LFE = 0output.SL = input.SLoutput.SR = input.SR
|
|
6 (5.1) |
1 (Mono) |
Heruntermischen von 5.1 auf Mono. Die linken ( L und
SL), rechten (R und SR) und zentralen
Kanäle werden alle zusammengemischt. Die Surround-Kanäle werden leicht
abgeschwächt, und die normalen seitlichen Kanäle werden leistungskompensiert,
sodass sie durch Multiplikation mit √2/2 als einzelner Kanal
zählen. Der Subwoofer-Kanal (LFE) geht verloren.output.M = 0.7071 * (input.L + input.R) + input.C + 0.5 * (input.SL + input.SR)
|
|
6 (5.1) |
2 (Stereo) |
Heruntermischen von 5.1 auf Stereo. Der zentrale Kanal ( C) wird mit jedem seitlichen Surround-Kanal (SL
oder SR) summiert und in jeden seitlichen Kanal gemischt.
Da auf zwei Kanäle heruntergemischt wird, erfolgt die Mischung mit geringerer
Leistung: In jedem Fall wird mit √2/2 multipliziert. Der
Subwoofer-Kanal (LFE) geht verloren.output.L = input.L + 0.7071 * (input.C + input.SL)output.R = input.R + 0.7071 * (input.C + input.SR)
|
|
6 (5.1) |
4 (Quad) |
Heruntermischen von 5.1 auf Quad. Der zentrale Kanal ( C)
wird mit den seitlichen Nicht-Surround-Kanälen (L und
R) gemischt. Da auf zwei Kanäle heruntergemischt wird, erfolgt
die Mischung mit geringerer Leistung: In jedem Fall wird mit
√2/2 multipliziert. Die Surround-Kanäle werden unverändert
durchgeleitet. Der Subwoofer-Kanal (LFE) geht verloren.output.L = input.L + 0.7071 * input.Coutput.R = input.R + 0.7071 * input.Coutput.SL = input.SLoutput.SR = input.SR
|
|
| Andere, nicht standardmäßige Layouts |
Nicht standardmäßige Kanallayouts verhalten sich, als wäre
channelInterpretation auf discrete gesetzt.Die Spezifikation erlaubt ausdrücklich die zukünftige Definition neuer Lautsprecherlayouts. Daher ist dieser Fallback nicht zukunftssicher, da sich das Verhalten der Browser für eine bestimmte Kanalanzahl künftig ändern kann. |
||
discrete |
beliebig (x) |
beliebig (y), wobei x<y |
Diskrete Kanäle hochmischen. Füllen Sie jeden Ausgangskanal mit seinem entsprechenden Eingangskanal – also dem Eingangskanal mit demselben Index. Kanäle ohne entsprechenden Eingangskanal bleiben stumm. |
beliebig (x) |
beliebig (y), wobei x>y |
Diskrete Kanäle heruntermischen. Füllen Sie jeden Ausgangskanal mit seinem entsprechenden Eingangskanal – also dem Eingangskanal mit demselben Index. Eingangskanäle ohne entsprechenden Ausgangskanal werden verworfen. |
|
Visualisierungen
Im Allgemeinen verwenden wir die Ausgabe über die Zeit, um Audiovisualisierungen zu erzeugen, und lesen dafür meist deren Verstärkungs- oder Frequenzdaten. Anschließend wandeln wir die erhaltenen Daten mithilfe eines Grafikwerkzeugs in eine visuelle Darstellung, beispielsweise ein Diagramm, um. Die Web Audio API stellt einen AnalyserNode bereit, der das durch ihn laufende Audiosignal nicht verändert. Außerdem gibt er die Audiodaten aus, sodass wir sie mithilfe einer Technologie wie <canvas> verarbeiten können.

Sie können Daten mit den folgenden Methoden abrufen:
AnalyserNode.getFloatFrequencyData()-
Kopiert die aktuellen Frequenzdaten in ein übergebenes
Float32Array-Array. AnalyserNode.getByteFrequencyData()-
Kopiert die aktuellen Frequenzdaten in ein übergebenes
Uint8Array(Array vorzeichenloser Bytes). AnalyserNode.getFloatTimeDomainData()-
Kopiert die aktuellen Wellenform- oder Zeitbereichsdaten in ein übergebenes
Float32Array-Array. AnalyserNode.getByteTimeDomainData()-
Kopiert die aktuellen Wellenform- oder Zeitbereichsdaten in ein übergebenes
Uint8Array(Array vorzeichenloser Bytes).
Hinweis: Weitere Informationen finden Sie in unserem Artikel Visualisierungen mit der Web Audio API.
Verräumlichung
Die Audioverräumlichung ermöglicht es uns, die Position und das Verhalten eines Audiosignals an einem bestimmten Punkt im physischen Raum zu modellieren und zu simulieren, wie der Zuhörer dieses Audio hört. In der Web Audio API wird die Verräumlichung durch PannerNode und AudioListener verarbeitet.
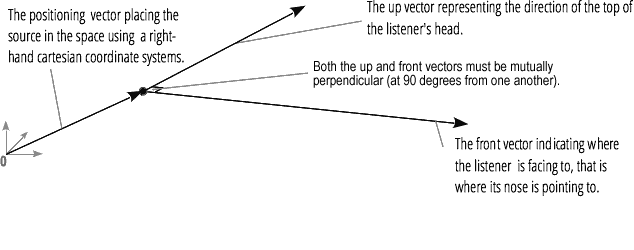
Der Panner verwendet rechtshändige kartesische Koordinaten, um die Position der Audioquelle als Vektor und ihre Orientierung als gerichteten 3D-Kegel zu beschreiben. Der Kegel kann beispielsweise bei omnidirektionalen Quellen recht groß sein.

Ebenso beschreibt die Web Audio API den Zuhörer mit rechtshändigen kartesischen Koordinaten: seine Position als einen Vektor und seine Orientierung als zwei Richtungsvektoren, up und front. Diese Vektoren definieren die Richtung des oberen Teils des Kopfes des Zuhörers sowie die Richtung, in die dessen Nase zeigt. Die Vektoren stehen senkrecht aufeinander.
Hinweis: Weitere Informationen finden Sie in unserem Artikel Grundlagen der Web-Audio-Verräumlichung.
Fan-in und Fan-out
Im Audiobereich beschreibt Fan-in den Prozess, bei dem ein ChannelMergerNode eine Reihe von Mono-Eingangsquellen aufnimmt und ein einzelnes Mehrkanalsignal ausgibt:

Fan-out beschreibt den umgekehrten Prozess: Ein ChannelSplitterNode nimmt eine Mehrkanal-Eingangsquelle auf und gibt mehrere Mono-Ausgangssignale aus:
