Sélection et parcours de l'arbre DOM
Dans le guide Anatomie du DOM, nous avons présenté les propriétés permettant de naviguer entre les parents, les enfants et les voisins, mais parcourir manuellement l'arbre est verbeux et sujet aux erreurs. Le DOM fournit des méthodes pour obtenir directement la référence à un élément dans l'arbre par un identifiant unique, un nom de classe, un nom de balise, un sélecteur CSS, et plus encore. Il fournit également des fonctions utilitaires pour itérer sur les nœuds de l'arbre.
Parcours de l'arbre : à un niveau élevé
Le guide Anatomie du DOM présente la structure arborescente du DOM. L'arbre a une racine, et chaque nœud possède une liste (éventuellement vide) d'enfants. La racine du document est un nœud Document, tandis que les nœuds Element forment l'épine dorsale de cet arbre.
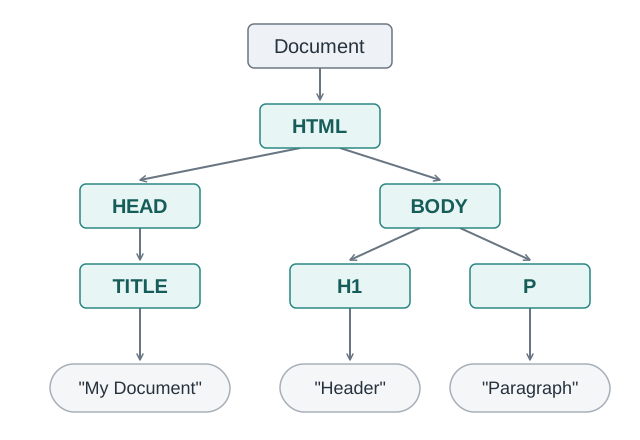
Il existe de nombreuses façons de parcourir un arbre (angl.), mais le DOM n'expose qu'un seul ordre : la recherche en profondeur d'abord en pré-ordre (DFS), appelée ordre du document ou ordre de l'arbre. En pseudo-code, le pré-ordre fonctionne ainsi :
function parcourirArbre(racine, visiteur) {
  // Visite la racine en premier
  visiteur(racine);
  for (const enfant of racine.childNodes) {
    // Parcourt récursivement chaque enfant dans l'ordre
    // Chaque sous-arbre enfant est complètement visité avant de passer au suivant
    parcourirArbre(enfant, visiteur);
  }
}
Un élément précède ses descendants, et les voisins plus anciens et leurs descendants précèdent les voisins plus récents. Par exemple, dans l'arbre ci-dessus, les nœuds Element listés dans l'ordre de l'arbre sont : HTML, HEAD, TITLE, BODY, H1, P.
La sélection n'est qu'une forme de parcours, le visiteur étant une fonction booléenne qui nous indique si nous nous intéressons à l'élément.
function selectionneArbre(racine, visiteur) {
  // le visiteur correspond avec succès au nœud racine ; retourner sans aller plus loin
  if (visiteur(racine)) return racine;
  for (const enfant of racine.childNodes) {
    const resultat = selectionneArbre(enfant, visiteur);
    // Un résultat est trouvé avec succès dans le sous-arbre à enfant
    if (resultat !== null) return resultat;
  }
  // Aucun résultat trouvé dans le sous-arbre à racine
  return null;
}

function selectionneArbreMulti(racine, visiteur, collection) {
  if (visiteur(racine)) collection.push(racine);
  for (const enfant of racine.childNodes) {
    selectionneArbreMulti(enfant, visiteur, collection);
  }
  return collection;
}
Une fois que vous comprenez cela, vous comprenez déjà une grande partie de la sélection et de la traversée du DOM. Il ne reste plus qu'à voir comment chaque méthode DOM spécialisée définit sa fonction visiteur et son objet collection pour vous.
Sélectionner des éléments par ID, classe ou nom de balise
Il existe trois principales façons d'identifier un élément : son id, son className et son tagName. L'interface Document fournit trois méthodes pour sélectionner par ces trois identifiants :
Comme leur nom l'indique, getElementById() retourne la référence à un seul élément (ou null si aucun élément n'est trouvé), tandis que getElementsByClassName() et getElementsByTagName() retournent des collections d'éléments. La collection est une HTMLCollection dynamique ; nous en discutons plus en détail dans Travailler avec des collections.
Chaque id d'élément doit être unique dans le document (mais les DOM d'ombre sont des documents séparés et ont donc leurs propres portées). Tant que vous respectez cette exigence dans votre code, vous obtenez toujours l'élément que vous souhaitez avec getElementById(). Cependant, les attributs id sont très rarement utilisés, car il est difficile de les maintenir uniques à l'échelle mondiale. Par conséquent, dans les applications réelles, vous trouvez souvent getElementsByClassName() et getElementsByTagName() (ou les méthodes de requête que nous présentons bientôt) plus pratiques.
<div id="conteneur"></div>
<div class="profil large"></div>
const divConteneur = document.getElementById("conteneur");
// divConteneur est un HTMLDivElement

const profilDivs = document.getElementsByClassName("profil");
// profilDivs est une HTMLCollection contenant un HTMLDivElement

const profilDivs2 = document.getElementsByTagName("div");
// profilDivs2 est une HTMLCollection contenant les deux HTMLDivElement
Quelques notes importantes à souligner :
- La méthode
getElementById()fait correspondre les ID en respectant la casse. La méthodegetElementsByClassName()fait également correspondre en respectant la casse, sauf en mode quirks, où la correspondance est insensible à la casse ASCII. - Dans les documents HTML,
getElementsByTagName()met en minuscules l'argument lors de la correspondance avec les éléments HTML. Les éléments non HTML (par exemple, SVG) sont toujours comparés en respectant la casse. Dans les documents XML, toutes les correspondances de noms de balises sont sensibles à la casse. Notez que letagNamed'un élément HTML dans un document HTML est retourné en majuscules, mais qu'il est toujours stocké en minuscules en interne. - La valeur de l'attribut
classest une liste séparée par des espaces d'un ou plusieurs noms de classe. Vous pouvez également définir une liste séparée par des espaces pourgetElementsByClassName(), et levisitorteste une relation de sous-ensemble. Autrement dit, un élément est sélectionné si tous ces noms de classe sont présents sur l'élément, et des noms de classe supplémentaires sur l'élément sont également autorisés. - La méthode
getElementsByTagName()prend la valeur spéciale"*"pour obtenir tous les éléments (c'est-à-dire appliquer aucun filtrage).
Si vous êtes familier avec les sélecteurs CSS, ces méthodes sont les équivalents DOM des sélecteurs d'ID, de classe, de type et universels :
/* document.getElementById("conteneur") */
#conteneur {
}

/* document.getElementsByClassName("profil") */
.profil {
}

/* document.getElementsByClassName("profil large") */
.profil.large {
}

/* document.getElementsByTagName("div") */
div {
}

/* document.getElementsByTagName("*") */
* {
}
La méthode getElementById() est également disponible sur DocumentFragment ; les méthodes getElementsByClassName() et getElementsByTagName() sont également disponibles sur Element. L'appel de la méthode sur un nœud définit la racine de recherche sur ce nœud. La racine appelante ne correspond jamais.
Sélectionner des éléments avec des sélecteurs CSS
Vous pouvez également utiliser directement des sélecteurs CSS pour sélectionner des éléments. Deux méthodes sont disponibles sur Document :
Les deux méthodes recherchent les descendants, en excluant le nœud sur lequel elles sont appelées. La méthode querySelector() retourne le premier élément correspondant ; la méthode querySelectorAll() retourne tous les éléments correspondants dans une NodeList statique. Nous présentons à nouveau cette collection de manière plus formelle dans Travailler avec des collections.
Pour sélectionner tous les éléments paragraphe (p) d'un document dont la classe inclut avertissement ou note, vous pouvez faire :
const special = document.querySelectorAll("p.avertissement, p.note");
Vous pouvez aussi interroger par identifiant. Par exemple :
const el = document.querySelector("#principal, #base, #exclamation");
Après l'exécution du code ci-dessus, el contient le premier élément du document dont l'ID est l'un de principal, base ou exclamation. L'ordre des sélecteurs dans la liste ne donne pas la priorité à un ID par rapport à un autre. Un élément qui correspond à plusieurs sélecteurs n'apparaît qu'une seule fois dans le résultat de querySelectorAll().
Les pseudo-classes, telles que :checked et :first-child, peuvent être utilisées dans les requêtes. Pour protéger la vie privée de l'utilisateur·ice, certaines pseudo-classes ne sont pas prises en charge ou se comportent différemment. Par exemple, :visited ne retourne aucun résultat et :link est traité comme :any-link. Seuls les éléments peuvent être sélectionnés, donc les pseudo-éléments, tels que ::before, ne produisent pas d'éléments DOM correspondants.
Les méthodes querySelector sont essentiellement des sur-ensembles des méthodes getElementBy introduites précédemment. Tout ce que vous pouvez implémenter avec ces dernières, vous pouvez obtenir des résultats similaires avec les premières :
document.getElementById("conteneur");
// Est équivalent à :
document.querySelector("#conteneur");

document.getElementsByClassName("profile large");
// Est équivalent à :
document.querySelectorAll(".profile.large");

document.getElementsByTagName("div");
// Est équivalent à :
document.querySelectorAll("div");
Il n'y a que deux points à surveiller :
-
Les méthodes
getElementsByClassName()etgetElementsByTagName()retournent des collections dynamiques, tandis quequerySelectorAll()retourne une collection statique (voir Collections dynamiques et statiques). En général, c'est le comportement de la collection statique que vous souhaitez. -
La chaîne de caractères de la syntaxe de sélecteur ; sinon, la méthode lance une
SyntaxErrorDOMException. Un ID ou un nom de classe HTML n'est pas nécessairement un identifiant CSS valide. UtilisezCSS.escape()lorsque vous insérez une telle valeur dans un sélecteur d'ID ou de classe :jsconst id = "element:42"; const element = document.querySelector(`#${CSS.escape(id)}`); // document.getElementById(id) a besoin d'aucun échappement.
Les deux méthodes de requête sont également disponibles sur DocumentFragment et Element. Appeler querySelector() ou querySelectorAll() sur un élément limite les éléments retournés à ses descendants, mais le sélecteur est appliqué dans le contexte de l'ensemble du document. Par exemple, étant donné ce HTML :
<div>
  <section id="principal">
    <p class="note">Un enfant direct.</p>
    <div>
      <p class="note">Un paragraphe imbriqué.</p>
    </div>
  </section>
</div>
Un sélecteur comme div p correspond toujours à la première note, car ce p est effectivement imbriqué dans un div, bien que ce div soit en dehors de la racine de recherche. Utilisez :scope pour appliquer le sélecteur uniquement dans la racine de recherche :
const principal = document.getElementById("principal");
const toutesLesNotes = principal.querySelectorAll("div p"); // Les deux paragraphes
const noteEnfant = principal.querySelectorAll(":scope div p"); // Seulement le second
const noteEnfant2 = principal.querySelectorAll(":scope > p"); // Seulement le premier
La méthode Element.matches() teste si un élément correspond à la chaîne de caractères de sélecteur, donc querySelector() fonctionne comme la fonction selectTree avec element.matches passé comme fonction visitor (malgré de nombreuses différences techniques).
Vous pouvez également rechercher vers le haut en utilisant la méthode Element.closest(). Cette méthode teste l'élément lui-même, puis son élément parent, et ainsi de suite jusqu'à la racine, jusqu'à ce qu'elle trouve un élément ancêtre qui correspond au sélecteur donné.
En utilisant le même HTML :
const noteInterieur = document.querySelector("#principal div p.note");
console.log(noteInterieur.closest("section").id); // "principal"
Travailler avec des collections
Nous avons déjà présenté deux types de collections :
HTMLCollectiondynamique est retourné pargetElementsByClassName()etgetElementsByTagName()NodeListstatique est retourné parquerySelectorAll()
Une NodeList peut contenir n'importe quel type de nœud, tandis qu'une HTMLCollection ne contient que des éléments (mais les éléments n'ont pas réellement besoin d'être des éléments HTML). Vous connaissez peut-être déjà la propriété Node.childNodes, qui est également une NodeList. La NodeList retournée par querySelectorAll() ne contient que des éléments, car cette méthode sélectionne des éléments.
Les deux interfaces sont semblables à des tableaux, ce qui signifie qu'elles ont une propriété length et prennent en charge l'accès indexé. Elles prennent également en charge l'itération.
const paragraphes = document.querySelectorAll("p");
console.log(paragraphes.length);
console.log(paragraphes[0]);

for (const para of paragraphes) {
  // …
}
Cependant, ce ne sont pas de vrais objets Array, donc ils n'ont pas de méthodes comme Array.prototype.map(). Si vous avez besoin de ces méthodes, vous pouvez les convertir en tableaux, en utilisant la syntaxe de décomposition ou Array.from():
const paragraphes = [...document.querySelectorAll("p")];
const paragraphes2 = Array.from(document.querySelectorAll("p"));

const textes = paragraphes.map((p) => p.textContent);
Les interfaces NodeList et HTMLCollection, ainsi que de nombreuses autres interfaces semblables à des tableaux sur le web, sont une tentative de créer une liste non modifiable (angl.). Elles ne fournissent aucun moyen de les modifier, et la modification des tableaux convertis n'affecte pas la liste originale.
HTMLCollection n'est pas seulement une liste ; c'est aussi une carte clé-valeur qui permet de rechercher par l'ID des éléments ou par le name des éléments HTML. Vous pouvez soit utiliser namedItem() soit y accéder directement en tant que propriétés (tant qu'elles ne sont pas en conflit avec les noms de propriétés existants de la HTMLCollection).
const sections = document.getElementsByTagName("section");
const principal = sections.namedItem("principal");
const principal2 = sections["principal"];
Les interfaces fournissent quelques méthodes pratiques supplémentaires :
- Les deux interfaces fournissent une méthode
item(), qui fonctionne comme un accès indexé. La principale différence est qu'elle retournenulllorsque l'index est hors de portée, tandis que l'accès indexé retourneundefined; elle applique également des règles de conversion d'entrée différentes. NodeListfournitforEach(),entries(),keys()etvalues(). Ils fonctionnent exactement de la même manière que les méthodesArray, donc si vous avez seulement besoin de ces méthodes, vous n'avez pas besoin de les convertir enArray.
Collections dynamiques et statiques
Les objets HTMLCollection retournés par getElementsByTagName() et getElementsByClassName() sont dynamiques. Essentiellement, la collection ne stocke rien à l'avance ; elle se souvient simplement de l'élément racine et de la requête. Lorsque vous essayez réellement de récupérer sa longueur ou un élément qu'elle contient, la collection effectue alors la traversée réelle de l'arbre DOM actuel. (Cela peut fonctionner différemment dans un vrai navigateur en raison des optimisations.) Par conséquent, si vous enregistrez la collection puis mettez à jour l'arbre DOM, la collection reflète désormais le dernier arbre DOM.
const conteneur = document.createElement("div");
const paragraphe = document.createElement("p");
paragraphe.className = "note";
conteneur.append(paragraphe);

const listeDynamique = conteneur.getElementsByClassName("note");
console.log(listeDynamique.length); // 1

paragraphe.classList.remove("note");
console.log(listeDynamique.length); // 0
En revanche, l'objet NodeList retourné par querySelectorAll() est statique, ce qui signifie qu'il s'agit d'un instantané de l'état de l'arbre au moment de l'appel de la méthode. Une liste statique préserve son appartenance, pas l'état des nœuds : elle fait toujours référence aux objets de nœuds d'origine.
const conteneur = document.createElement("div");
const paragraphe = document.createElement("p");
paragraphe.className = "note";
conteneur.append(paragraphe);

const listeStatique = conteneur.querySelectorAll(".note");
console.log(listeStatique.length); // 1

paragraphe.classList.remove("note");
console.log(listeStatique.length); // 1
console.log(listeStatique[0].className); // ""
Généralement, une liste statique est ce que vous voulez. Vous voulez presque toujours convertir les collections en tableaux de toute façon pour utiliser les méthodes de tableau, auquel cas la collection n'est plus dynamique. De plus, si vous modifiez une collection dynamique tout en itérant dessus, ses indices et sa longueur peuvent changer, créant des modifications concurrentes inattendues :
const notes = document.getElementsByClassName("note");
for (const note of notes) {
  // Cela supprime simultanément cet élément de la collection, décalant
  // tous les éléments suivants, de sorte que l'itération suivante ne
  // visite pas l'élément suivant
  note.classList.remove("note");
}
Pour résoudre ce problème, itérez sur un instantané, comme un tableau créé avec Array.from(notes) ou une liste statique obtenue avec querySelectorAll(".note"). Alternativement, différer les mutations qui modifient l'appartenance ou l'ordre de la collection jusqu'après l'itération. Vous pouvez toujours conserver une référence à la collection dynamique pour observer les mises à jour ultérieures.
Parcourir les nœuds
Les méthodes de sélection peuvent être utilisées pour itérer sur les éléments, comme ceci :
for (const descendant of element.querySelectorAll("*")) {
  // Visite chaque élément descendant de ce sous-arbre
}
Cependant, cette méthode reste assez limitée : vous ne pouvez pas parcourir les nœuds qui ne sont pas des éléments, comme les nœuds texte ou les commentaires, et vous ne pouvez pas éviter de parcourir un sous-arbre particulier sans écrire des sélecteurs complexes. Le DOM fournit deux interfaces pour le parcours général : NodeIterator et TreeWalker. Par exemple, le code suivant parcourt tous les nœuds, y compris les nœuds texte et les commentaires :
const iterateurNoeud = document.createNodeIterator(document);
let noeud = iterateurNoeud.nextNode();
while (noeud) {
  console.log(noeud.nodeName);
  noeud = iterateurNoeud.nextNode();
}
Pour créer un NodeIterator ou un TreeWalker, appelez respectivement document.createNodeIterator() ou document.createTreeWalker(). Les deux méthodes prennent les trois mêmes arguments :
root: le nœud à partir duquel le parcours commence.whatToShowFacultatif : définit les types de nœuds à parcourir. Un nœud qui n'est pas parcouru peut tout de même avoir des descendants qui le sont. La valeur par défaut estNodeFilter.SHOW_ALL.filterFacultatif : une fonction, ou un objet doté d'une méthodeacceptNode(node), qui restreint davantage les nœuds parcourus. La fonction peut décider si un nœud doit être ignoré et, le cas échéant, si ses descendants doivent l'être également (uniquement pourTreeWalker). La valeur par défaut estnull, ce qui signifie qu'aucun filtrage supplémentaire n'est appliqué.
Les deux objets exposent ces paramètres par leurs propriétés en lecture seule root, whatToShow et filter.
L'interface NodeFilter fournit des constantes pour whatToShow.
| Constante | Nœuds affichés |
|---|---|
NodeFilter.SHOW_ALL |
Tous |
NodeFilter.SHOW_ATTRIBUTE |
Attr |
NodeFilter.SHOW_CDATA_SECTION |
CDATASection |
NodeFilter.SHOW_COMMENT |
Comment |
NodeFilter.SHOW_DOCUMENT |
Document |
NodeFilter.SHOW_DOCUMENT_FRAGMENT |
DocumentFragment |
NodeFilter.SHOW_DOCUMENT_TYPE |
DocumentType |
NodeFilter.SHOW_ELEMENT |
Element |
NodeFilter.SHOW_PROCESSING_INSTRUCTION |
ProcessingInstruction |
NodeFilter.SHOW_TEXT |
Text |
Note :
La constante NodeFilter.SHOW_ATTRIBUTE n'est efficace que lorsque la racine est un nœud attribut. Comme le parent de tout nœud Attr est toujours null, TreeWalker.nextNode() et TreeWalker.previousNode() ne retournent jamais de nœud Attr. Pour parcourir les nœuds Attr, utilisez plutôt Element.attributes.
Toutes ces constantes sont des masques de bits, vous pouvez donc combiner les constantes avec l'opérateur OU binaire (|) pour inclure plusieurs types de nœuds, par exemple NodeFilter.SHOW_ELEMENT | NodeFilter.SHOW_TEXT pour inclure à la fois les nœuds élément et texte.
Un nœud qui ne satisfait pas whatToShow n'est jamais transmis à la fonction filter. Il peut toutefois avoir des descendants qui sont parcourus.
La fonction filter (ou sa méthode acceptNode()) est appelée lorsque le parcours évalue un nœud candidat dont le type correspond à whatToShow. Les descendants d'un sous-arbre rejeté par TreeWalker peuvent ne jamais être transmis au filtre. Le filtre doit retourner l'une de ces constantes :
NodeFilter.FILTER_ACCEPT: entraîne le retour effectif du nœud.NodeFilter.FILTER_SKIP: entraîne l'omission du nœud, mais ses descendants restent pris en compte.NodeFilter.FILTER_REJECT: pourTreeWalker, entraîne l'omission du nœud et de tous ses descendants ; pourNodeIterator, cette constante se comporte commeFILTER_SKIP.
Par exemple, le code suivant parcourt tous les nœuds texte qui ne contiennent pas uniquement des espaces blancs :
const iterateur = document.createNodeIterator(
  document.body,
  NodeFilter.SHOW_TEXT,
  (noeud) =>
    noeud.data.trim() ? NodeFilter.FILTER_ACCEPT : NodeFilter.FILTER_SKIP,
);
Itérer dans l'ordre de l'arbre avec NodeIterator
Un objet NodeIterator parcourt les nœuds dans l'ordre de l'arbre avec la méthode nextNode() et dans l'ordre inverse avec la méthode previousNode(). Chaque appel retourne un nœud accepté par le filtre, ou null s'il n'existe aucun nœud de ce type dans cette direction.
En poursuivant l'exemple précédent, vous pouvez avancer en continu dans l'ordre de l'arbre et afficher chaque nœud texte dans la console :
let noeud;
while ((noeud = iterateur.nextNode())) {
  console.log(noeud.data);
}
De manière abstraite, NodeIterator fonctionne comme s'il conservait une liste de nœuds qui satisfont le filtre, triés dans l'ordre de l'arbre (mais il ne les stocke pas réellement). L'itérateur suit une position située entre deux nœuds de cette liste, exposée par referenceNode et pointerBeforeReferenceNode. La méthode nextNode() retourne le nœud immédiatement à droite de cette position, tandis que previousNode() retourne celui qui se trouve immédiatement à gauche. Au départ, referenceNode correspond à la racine et pointerBeforeReferenceNode vaut true. Le premier appel à nextNode() retourne donc la racine si elle satisfait les filtres, tandis que le premier appel à previousNode() retourne null, car aucun nœud ne se trouve à gauche. Après un appel réussi à nextNode(), referenceNode correspond au nœud retourné et pointerBeforeReferenceNode vaut false ; l'inverse se produit avec previousNode(). Par conséquent, inverser le sens du parcours retourne de nouveau le même nœud s'il satisfait toujours les filtres.
Parcourir l'arbre filtré avec TreeWalker
NodeIterator expose les nœuds filtrés comme une collection linéaire, ce qui est pratique pour l'itération mais ne préserve pas la structure de l'arbre. Un TreeWalker permet de naviguer dans les relations entre les nœuds dans une vue filtrée de l'arbre.
De manière abstraite, TreeWalker fonctionne comme s'il conserve un arbre de nœuds qui ont passé le filtre, de sorte que pour chaque nœud dans la vue filtrée, ses enfants directs sont ses descendants dans l'arbre original s'il n'y a pas de nœud intermédiaire qui passe également le filtre. Rappelez-vous que NodeFilter.FILTER_SKIP ignore un nœud mais permet à ses descendants de passer, tandis que NodeFilter.FILTER_REJECT ignore un nœud et tous ses descendants.
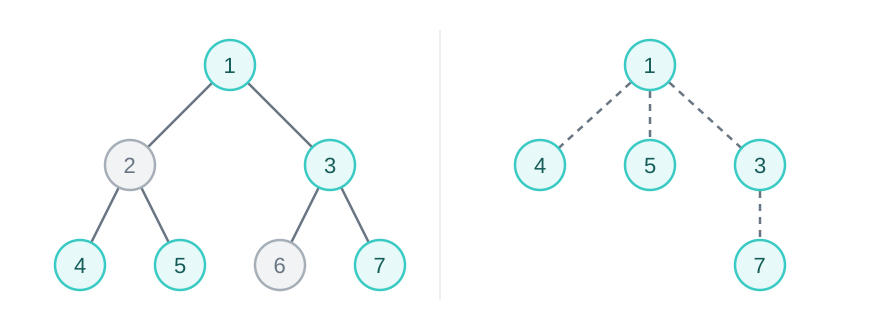
Sa propriété currentNode commence à la racine, même si la racine ne passe pas les filtres. Contrairement à un NodeIterator, appeler nextNode() commence la recherche après ce nœud courant, donc la racine elle-même n'est jamais retournée lors du premier appel.
Les méthodes suivantes déplacent currentNode dans la vue filtrée. Si aucun nœud correspondant n'est trouvé, elles retournent null et laissent currentNode inchangé : parentNode(), firstChild(), lastChild(), previousSibling(), nextSibling().
Notez que la vue filtrée peut ne pas être un arbre unique si la racine ne passe pas le filtre. Utilisez previousNode() et nextNode() pour trouver le nœud précédent/suivant qui passe le filtre dans l'ordre de l'arbre, qui peut appartenir à un arbre filtré différent. Ces méthodes retournent également null et laissent currentNode inchangé si aucun nœud correspondant n'est trouvé.
Contrairement à referenceNode d'un itérateur, currentNode est modifiable. Vous pouvez le sauvegarder et le réassigner plus tard, ou réinitialiser le marcheur à sa racine avec walker.currentNode = walker.root. L'assignation n'applique pas les filtres et ne vérifie pas que le nœud se trouve dans le sous-arbre de la racine, donc gardez-le dans ce sous-arbre lorsque vous voulez que le parcours y reste.
Par exemple, étant donné ce HTML :
<article id="article">
  <p>Lisez <strong>ce</strong> paragraphe.</p>
  <aside data-skip><p>Ignorez cette note.</p></aside>
  <p>Lisez également ce paragraphe.</p>
</article>
Ce marcheur collecte les nœuds de texte non blancs tout en excluant les sous-arbres marqués avec data-skip :
const article = document.getElementById("article");
const marcheur = document.createTreeWalker(
  article,
  NodeFilter.SHOW_ELEMENT | NodeFilter.SHOW_TEXT,
  (noeud) => {
    if (noeud.nodeType === Node.ELEMENT_NODE) {
      return noeud.hasAttribute("data-skip")
        ? NodeFilter.FILTER_REJECT
        : NodeFilter.FILTER_SKIP;
    }
    return noeud.data.trim()
      ? NodeFilter.FILTER_ACCEPT
      : NodeFilter.FILTER_SKIP;
  },
);

const morceaux = [];
let noeud;
while ((noeud = marcheur.nextNode())) {
  morceaux.push(noeud.data);
}
console.log(morceaux.join(""));
// "Lisez ce paragraphe.Lisez aussi ce paragraphe."
SHOW_ELEMENT est nécessaire même si nous ne collectons que du texte, car cette constante permet au filtre d'examiner et de rejeter les éléments dotés de data-skip. Avec SHOW_TEXT seul, ces éléments sont ignorés avant l'appel du filtre, et leur texte est tout de même parcouru. Comme NodeIterator ne tient pas compte de la structure de l'arbre, il ne permet pas d'exclure des sous-arbres entiers.
Résumé
Voici les fonctionnalités utiles pour sélectionner des éléments dans l'arbre DOM ou parcourir les nœuds :
- Pour sélectionner des éléments par ID, classe ou nom de balise :
getElementById()(également disponible surDocumentFragment),getElementsByClassName()etgetElementsByTagName()(ces deux dernières méthodes sont également disponibles surElement). - Pour sélectionner des éléments avec des sélecteurs CSS :
querySelector()pour la première correspondance ouquerySelectorAll()pour toutes les correspondances. Les deux méthodes sont également disponibles surDocumentFragmentetElement. - Pour tester un élément ou rechercher ses ancêtres :
matches()etclosest(). - Les interfaces
NodeListetHTMLCollectionsont des collections de nœuds ou d'éléments semblables à des tableaux qui fournissentlength, l'accès par indice, l'itération etitem().NodeListfournit égalementforEach(),entries(),keys()etvalues().HTMLCollectionfournitnamedItem()et l'accès aux propriétés nommées. document.createNodeIterator()crée un objetNodeIteratorqui parcourt les nœuds de manière séquentielle au moyen de ses méthodesnextNode()/previousNode(). Sa position est exposée parreferenceNodeetpointerBeforeReferenceNode.document.createTreeWalker()crée un objetTreeWalkerqui parcourt les nœuds dans la vue filtrée de l'arbre au moyen de ses méthodesparentNode(),firstChild()/lastChild(),previousSibling()/nextSibling()etpreviousNode()/nextNode(). Sa position est exposée parcurrentNode.- Les masques de bits
NodeFilter.SHOW_*sélectionnent les types de nœuds, et une fonction de filtre ou une méthodeacceptNode()retourneFILTER_ACCEPT,FILTER_SKIPouFILTER_REJECT. SeulTreeWalkerutiliseFILTER_REJECTpour élaguer des sous-arbres.
Voir aussi
- Anatomie du DOM
- Les sélecteurs CSS
- La méthode
Element.querySelector() - La méthode
Element.querySelectorAll() - La méthode
Document.querySelector() - La méthode
Document.querySelectorAll() - L'interface
NodeIterator - L'interface
TreeWalker - La norme DOM : parcours (angl.)
- La spécification des sélecteurs (angl.)